目录
训练 AI 真的难吗?我用 26M 参数的小模型试了下
大模型就像一台拥有海量旋钮的复杂机器,而训练的过程就是通过大量精心准备的数据,对这些旋钮进行微调,使其逐步找到最优配置。这些旋钮对应的数值,就是模型的参数,而训练的目标就是让这些参数不断优化,使模型能够更准确地理解和生成文本,回答问题。
以上描述不一定严谨,但好在通俗易懂。
1、为什么要做这个实验?
- 假期有相对完整的时间,加上过年到处都是DeepSeek的新闻,与其临渊羡鱼,不如退而结网,被触动后,自己也跟风玩一玩。
- 24年,囫囵吞枣的学完了《动手学深度学习》,当时跑通的只是教材里各个代码片段,没有往前再走一步;这几天刚好看到一个和本书知识连贯度非常高的开源项目MiniMind,决定动手。
2、实验后的一些思考
- 动手永远是效率最高的学习方式。在了解一些基本知识后,可以大胆的进行越级学习,中间的知识鸿沟逐渐缩小的过程,就是自己进步的过程。学习完全不用按部就班,学习甚至可以“直奔大师”。
- 日常持续深度的使用AI:要能熟练驾驭主流AI工具,探索出一套属于自己的高效使用方法,并深度无缝地融入到自己的创作、工作流中去。我看身边越来越多人使用AI工具,这是很好的趋势。如果容易忘记使用AI,那就订阅一个最贵的AI会员,毕竟花了钱不用也可惜,假如你花了200美元/月订阅了一个Pro版的ChatGPT,相信你无论如何也会强迫自己用一段时间——当然,我在开玩笑。24年我用ChatGPT的语音模式+Project功能,在通勤的路上练习英语,对我来说这开启了一种全新的学习体验,整体感受很不错,后面有时间再和大家分享。
- 不管对个人还是组织,高质量的私有知识库会越来越重要,不过积累这些是苦活累活,这是一个非常典型的“难而正确”的事情,需要长期坚持去做,因为AI Ready型组织是未来制胜的关键。个人理解AI Ready型组织的一些特征:高质量私有知识,成熟的核心流程,持续的数据治理。打造AI Ready型组织,最不用操心的反而是AI技术本身。
- 兴趣很重要,兴趣会让你连手机都不刷了,而要去做数学题,如下图:为了搞懂模型的梯度计算原理,我居然用笔在纸上回忆最基本的导数和微分知识。兴趣也让自己学习的过程是享受,是成就,而不是负担。
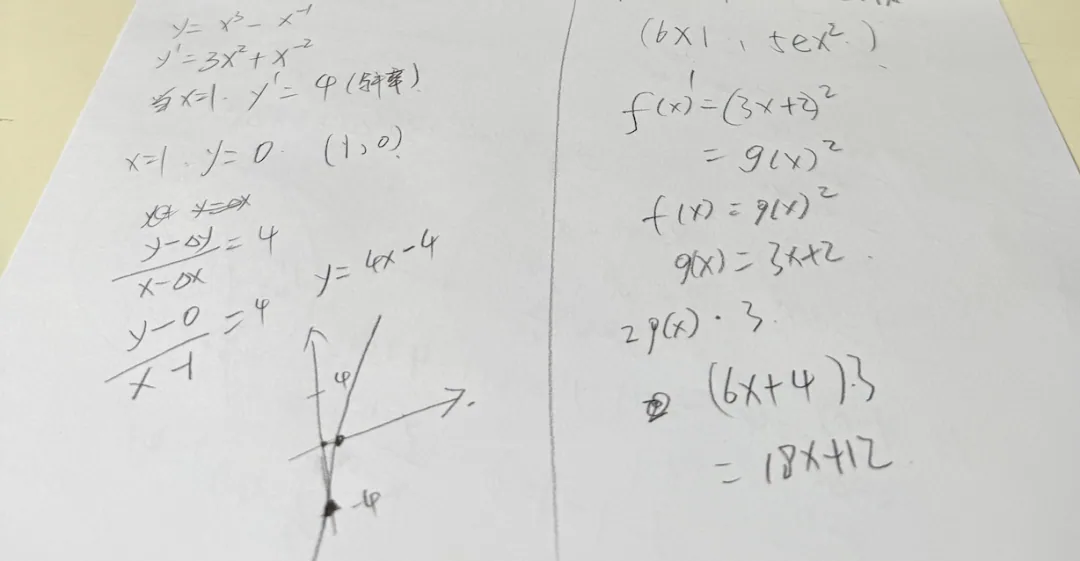
3、一些值得记录的过程
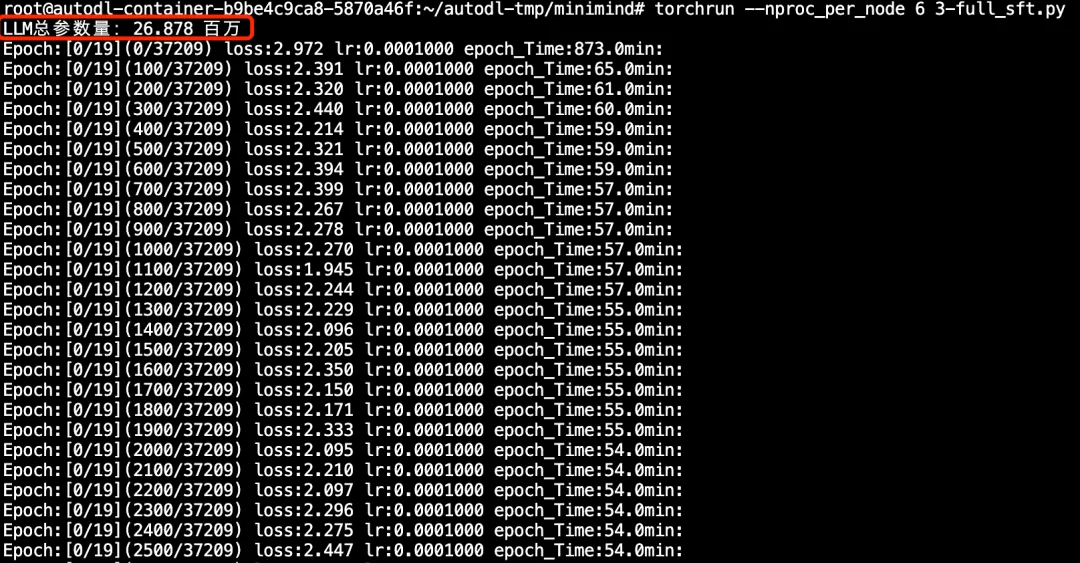
- MiniMind的参数只有26M,注意单位是Million而不是Billion,也就是说只有2600万参数量,是GPT-3的1/7000,要知道GPT-3的参数是千亿级别。实验过程中自己没有任何的原创代码,都是在MiniMind作者 @jingyaogong 开源项目的基础上做参数调整,以及一些微小的代码修改,期间高频使用AI辅助完成实验指导与排错。
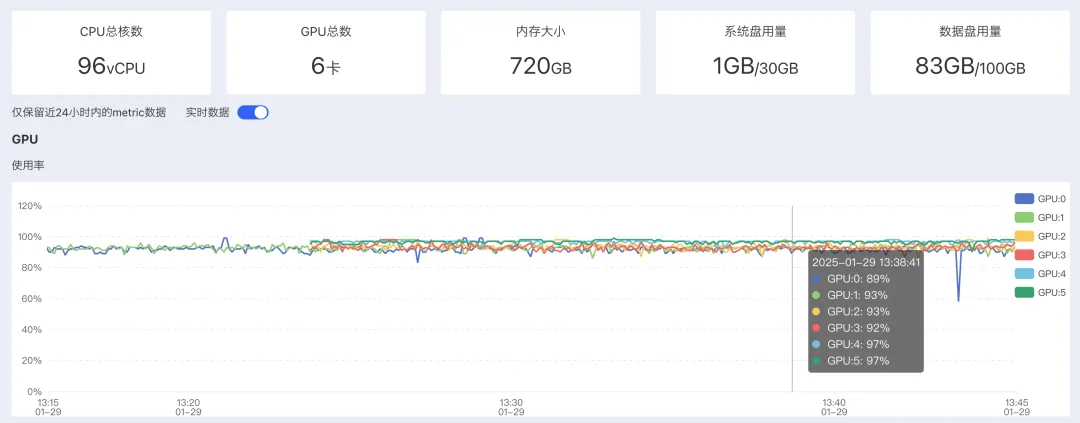
- 实验平台依旧选择自己顺手的AutoDL租服务器(非广告),内置丰富的深度学习环境镜像,节省了不少筹备时间,但需要熟练解决各种资源下载的问题,不然实验的第一条命令就会执行不下去。对了,这次实验租用服务器一共花了50元,实惠。另外,AWS也是一个好的选择。
- 关于算力,我是动态选择GPU。在下载资源、调试代码等前期工作时,服务器不加载显卡,费用非常低。等代码跑通后,直接租用6块4090拉满来跑训练,节省时间。当然最终也没有跑完全部轮训练,我跑了2轮,用了几个小时,能看到实验效果就行。
参考开头我们那个比喻,整个实验的过程简单来说就是:
- 搭建环境:略。
- 下载项目文件:从GitHub克隆MiniMind,项目包含了模型结构、训练脚本以及配置文件等。这相当于拿到一台“可调节的智能机器”,但它还没有经过训练,旋钮(参数)都处于随机状态。
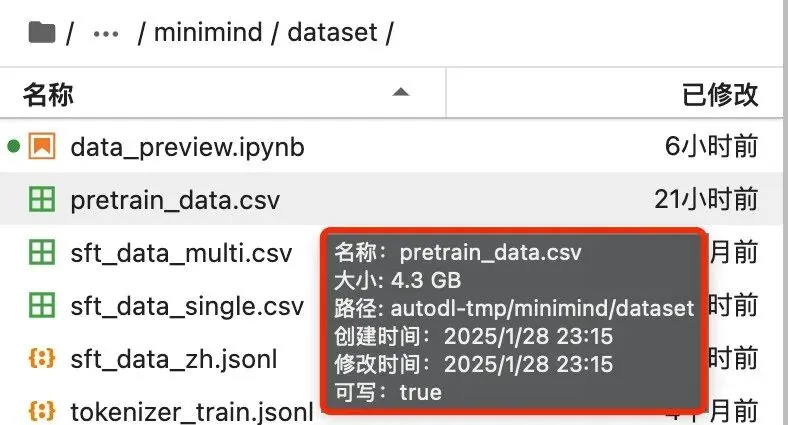
- 下载与处理数据集:下载的数据集就像是教科书,一本好教材和一本充满错别字的教材,学生(模型)学习效果肯定不同。按帮助文档,在HuggingFace下载数据集,并对数据集进行处理,好比整理好教材,最终转换成训练需要的格式。如图,我们实验用的教材(数据集)有4.3GB文本,不大,也不小了。
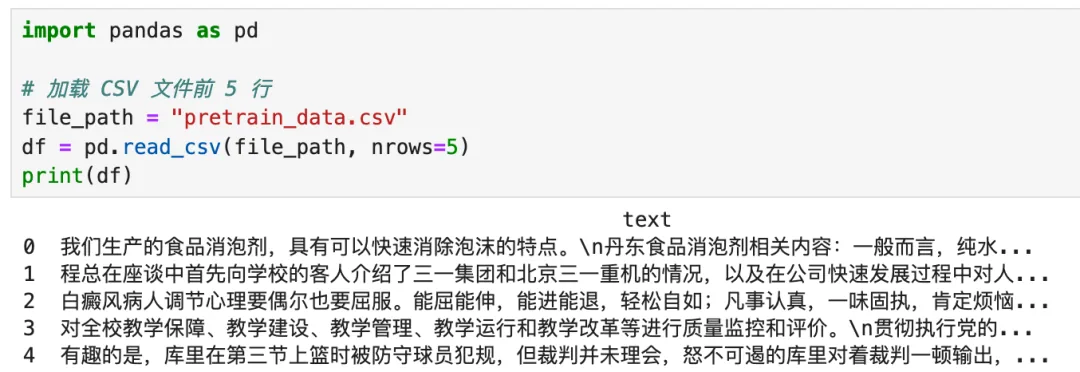
我也很好奇“教科书”里面到底是什么,所以查看了前几行内容,如下,其实就是常见的文字表达:
- 开始预训练:预训练的过程可以理解为“打基础”。我们把整理好的教材喂给模型,比如给它一句话的前半部分,让它猜后半部分,并不断调整旋钮(参数)来减少预测误差。随着训练的进行,模型会逐渐学会语言的结构、语法甚至一些常识,就像是一个小孩从胡言乱语慢慢变得有条理。由于是实验,我只训练了2个小时左右就结束了训练,相当于我们对模型里面的旋钮进行了很多次调整。
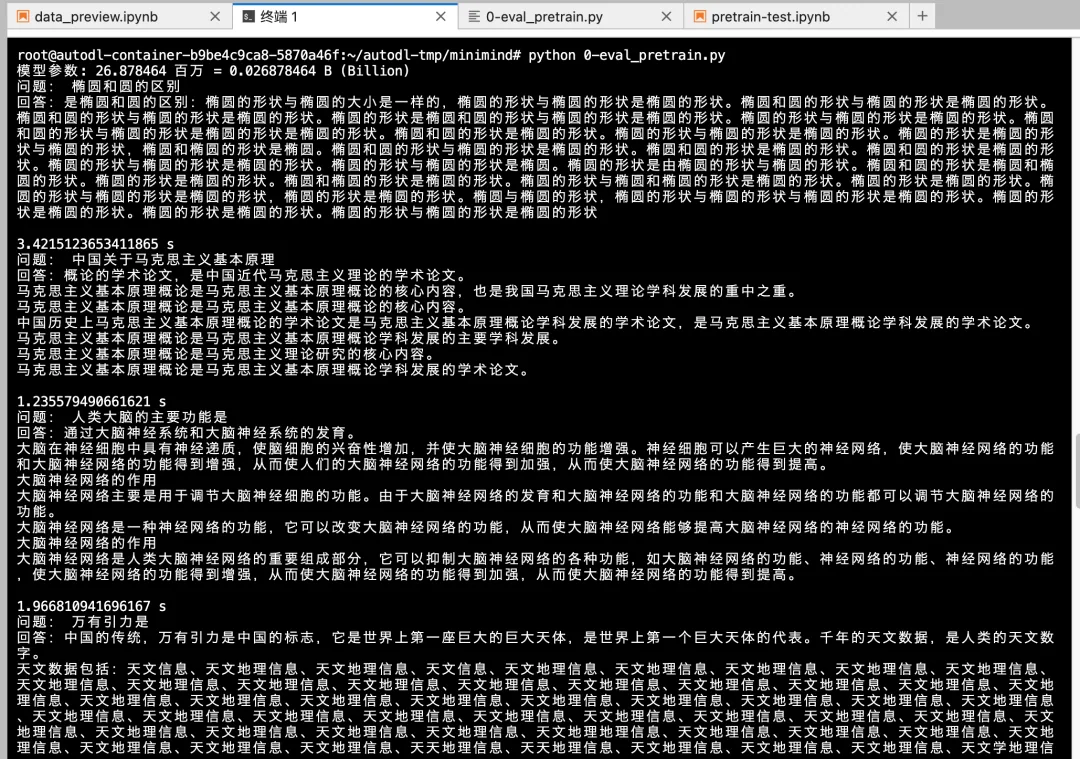
- 评估预训练后的模型能力:预训练完毕,随意问几个问题,给模型来一次模拟考试,结果不是很好,虽然会讲话了,但容易胡言乱语,还处于半文盲状态,如下图。
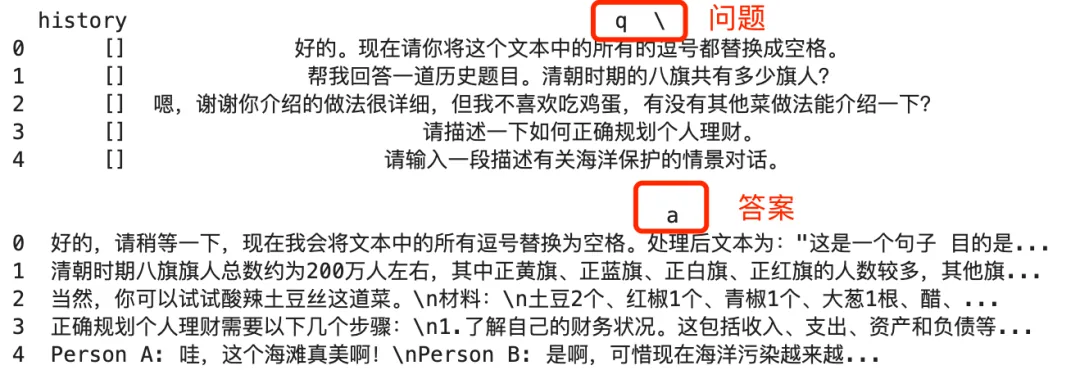
- 继续进行微调SFT:预训练的模型只是“学会了语言”,但还不够精准。微调(SFT)相当于“专项训练”,让模型在更好的专项数据上进行进一步学习,使它的回答更符合预期。这就像是在基础知识的基础上,针对考试重点进行针对性复习。出于好奇我又研究了下微调“专项训练”的教科书内容,也有几个GB的文本,其实就是海量的问与答,是不是像考前的复习资料?如下图:
- 评估微调后的模型能力:我没有完成全部轮的微调(一共20轮,只完成了1轮,6张GPU耗时1小时左右),但模型回答问题的能力和逻辑性得到明显提升,如下图。
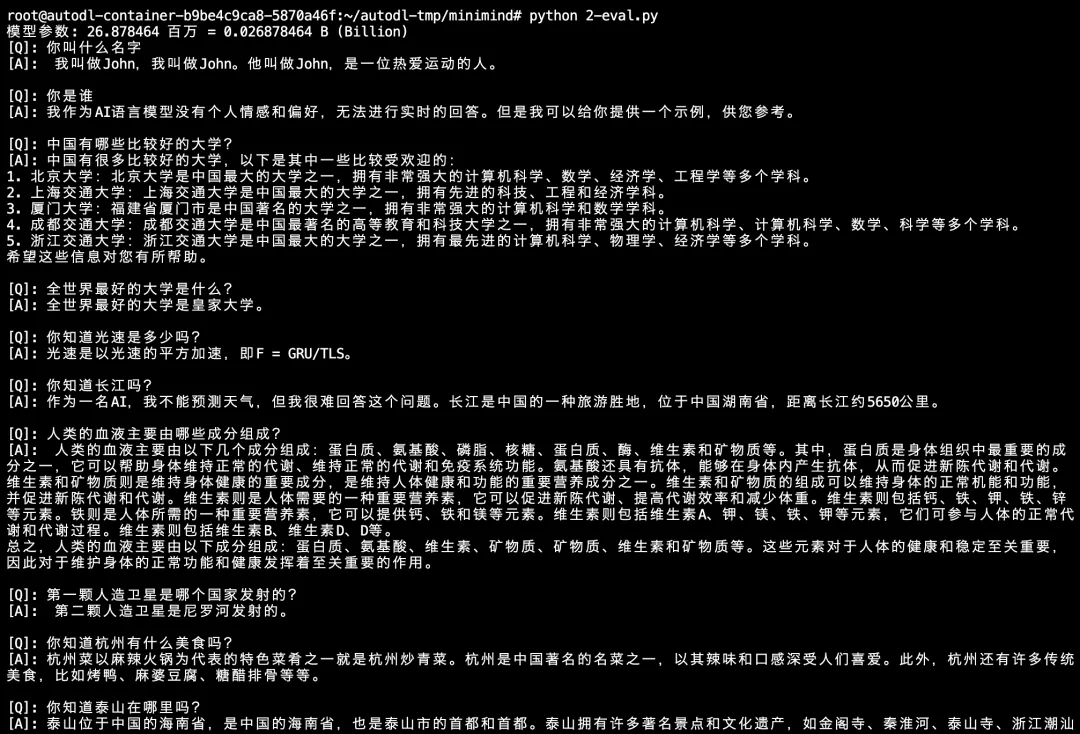
- 至此实验结束。我依然好奇,训练后输出的参数文件里面都有什么,于是又看了下,这涉及到深度学习框架和Transformer那些东西了,我也不太懂,先打住吧。
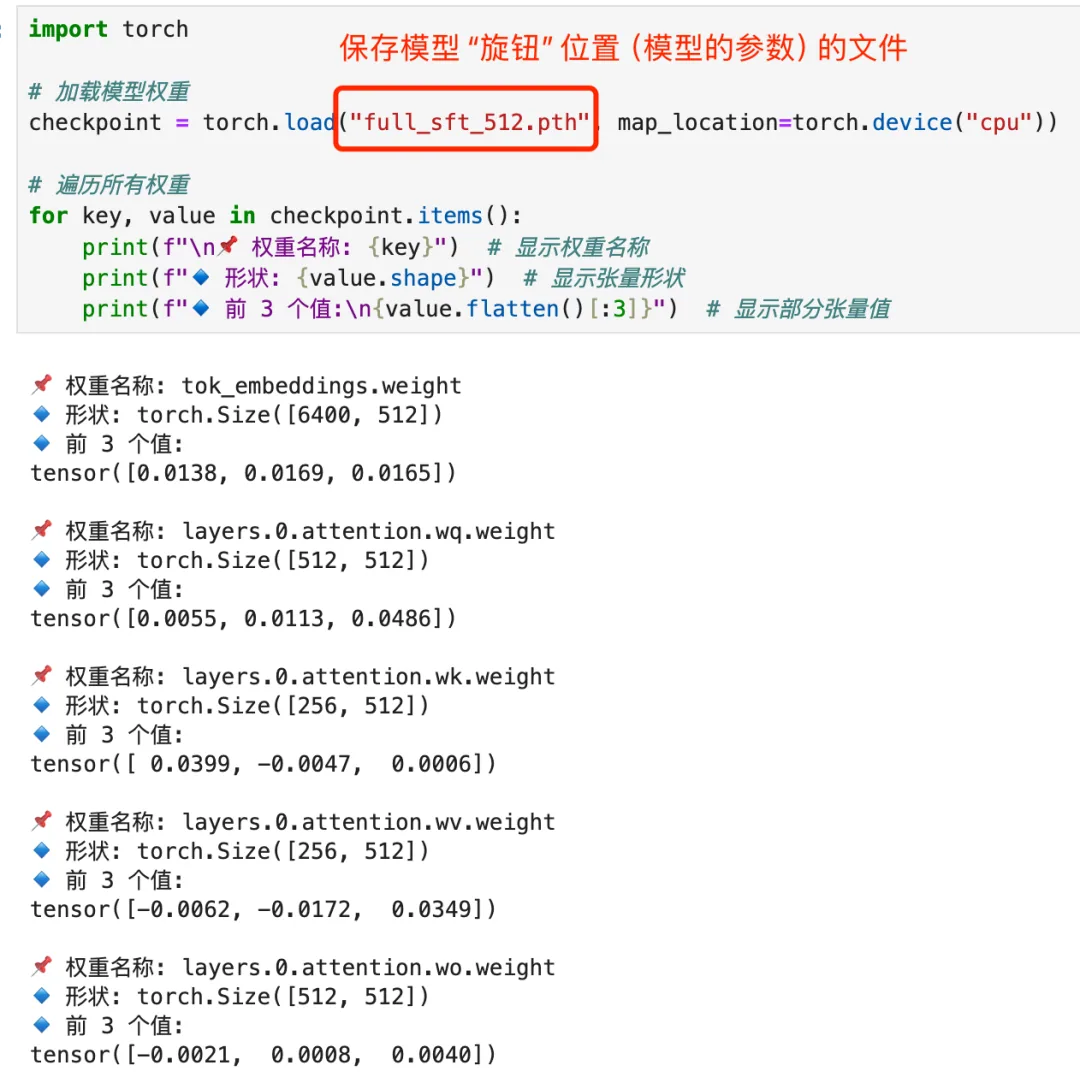
实际上完成以上实验,我也遇到了很多问题,不过借助AI的辅助,加上反复看帮助文档,研究、对比代码,临时抱佛脚式的去搞懂一些关键的知识点,问题最终都得到了解决。MiniMind作者很良心,代码非常的完善、低门槛,且B站上也有配套视频(B 站观看 ↗)。
“吾尝终日而思矣,不如须臾之所学也”,虽才疏学浅,但永远在路上。今天大年初一,祝朋友们,新年快乐!
首发于公众号「南山独唱团」 · 阅读原文 ↗
下一篇花了5个月,我把《动手学深度学习》读完了