大模型入门:你需要知道的关键知识
当答案触手可及时,提问的智慧与行动的勇气,更显关键。
降低大模型“幻觉”的同时,也会降低其创造力,这好比创新需要涌现,但不是每一个涌现都有意义。
面向所有人,一些必要的大模型知识
关于大模型的热点新闻和技术创新层出不穷,每天都目不暇接,但背后的运行框架和核心原理却并未有本质变化。尽管大模型的能力持续提升,但要想真正从中创造业务价值,依然需要高质量的知识沉淀、持续的数据治理、创新的思维方式,以及“驾驭”大模型的能力。在充满变化的时代,更要看清“变”与“不变”:江河奔腾不息,大山岿然不动。水在动,山不动。
我们今天主要来聊一些暂时“不动”的知识,我筛选了下,认为以下这些概念,所有人可能都需要了解:大模型,参数,预训练,微调,泛化,提示词,推理,MoE(混合专家),幻觉。我们尽量用通俗、最简单的语言来解释这些概念。
大模型:最常见的是大语言模型LLM,通过分析海量文本规律(如:人类文明级别),实现用语言理解世界的能力。可以将其比喻成:一台有数十亿旋钮的机器。还有其他类的大模型,比如图片和视频生成,这种归属为多模态模型。
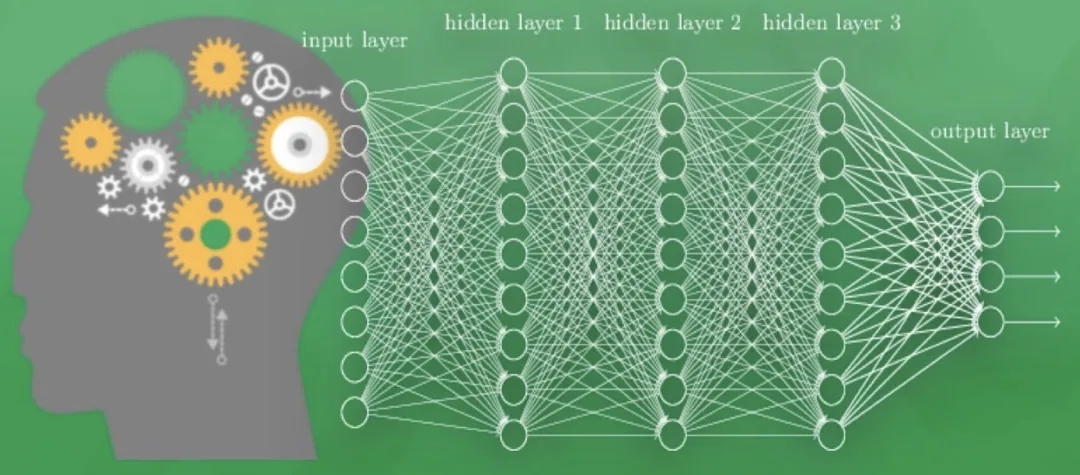
参数:相当于模型机器内部的旋钮,有数十亿个(目前已有数万亿规模),通过训练,不断调节各旋钮的位置,最终记录从数据中学到的知识(是发现规律,而非直接记住)。参数越大,模型能力越强,也更耗资源。参数不是越大越好,而是要合适。下图是我找到的,能比较形象、又不失严谨的一个大模型示意图:前面是输入input(提问),末尾是输出output(答案),中间那些线,就是简化的神经网络结构。
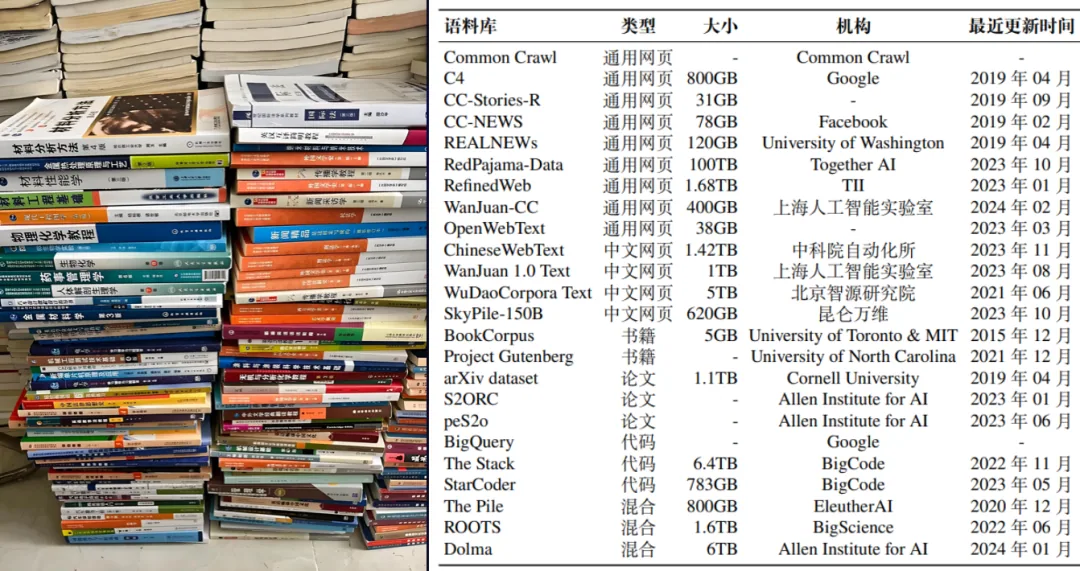
预训练:刚开始这些海量的旋钮位置是随机的,此时大模型就是一个文盲。预训练相当于拿大量优质的教科书,给大模型上学,使其掌握通识知识,学历达到本科水平。预训练消耗的资源非常庞大,对算力和网络要求极高,俗称“炼丹”。
微调:拿专业领域的教科书,继续让模型学习,使其变为该领域的专家,学历达到领域内研究生或者博士水平。
泛化:大模型的举一反三的能力,能回答未知问题,“融会贯通”地创造知识。通过训练找到了海量知识的规律,而不是简单的记住知识。
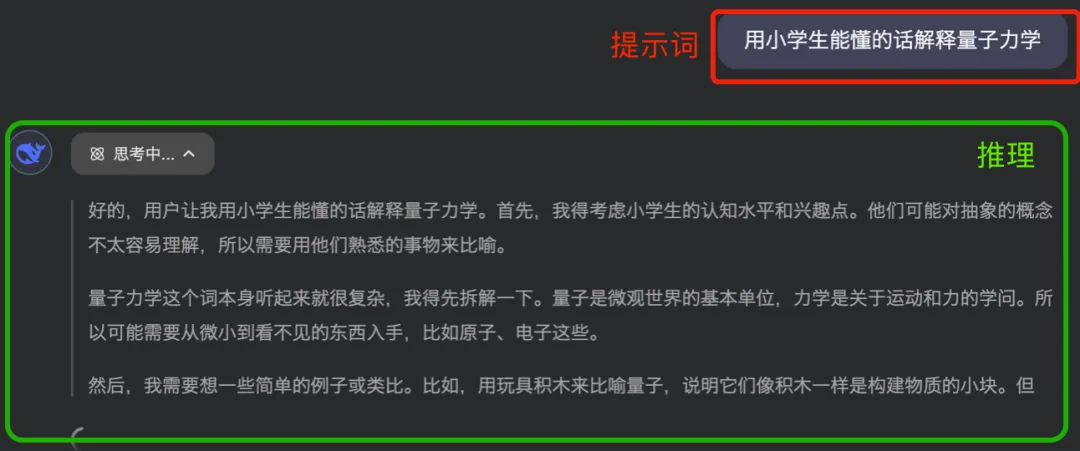
提示词:给大模型布置任务,使其输出能达到你的意图,如“用小学生能懂的话解释量子力学’。提示词也是驾驭大模型的一种能力。
推理:接收到提示词后,大模型根据要求开始答题,输出结果。相比预训练,这里消耗的GPU资源要小很多,网络方面,25G+100G的RoCE以太网交换机大部分可满足。
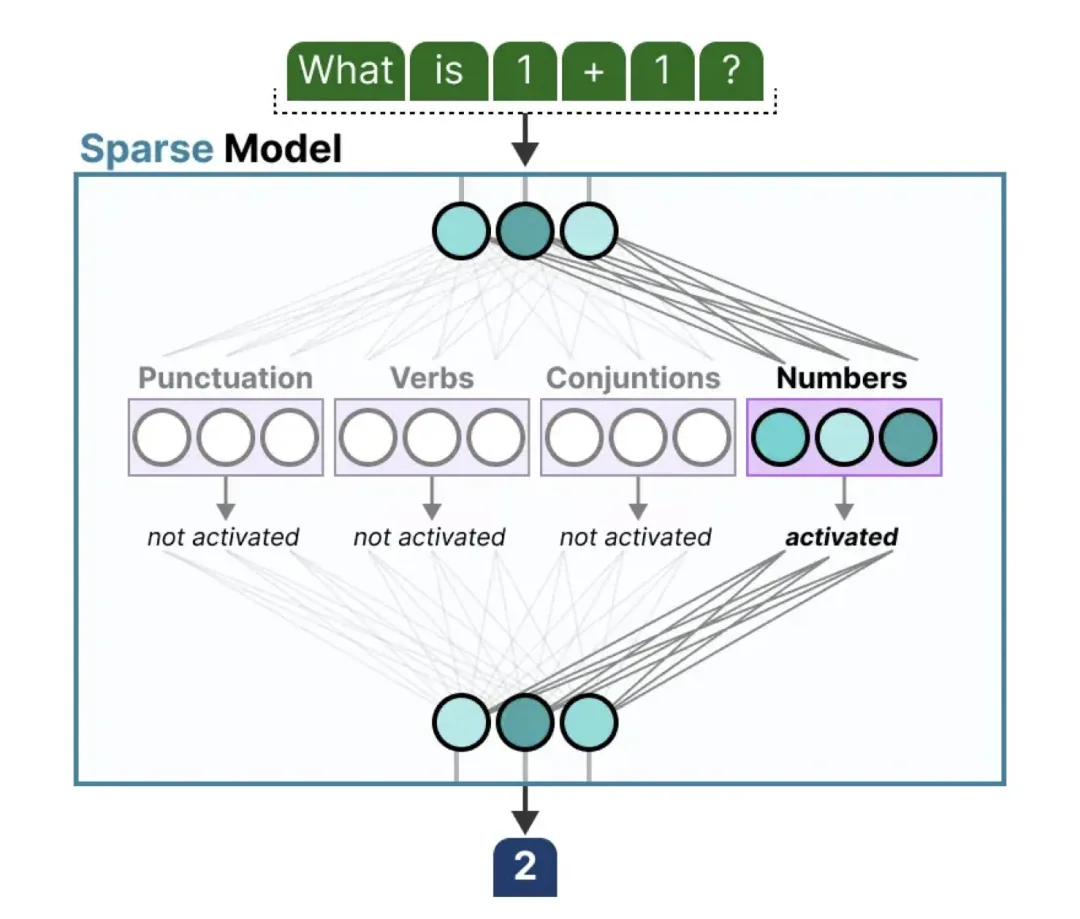
MoE(混合专家):大模型的多部门协作:不同任务自动调用不同子模型(如翻译用A/写代码用B),避免全程使用全部“旋钮”,提升效率。
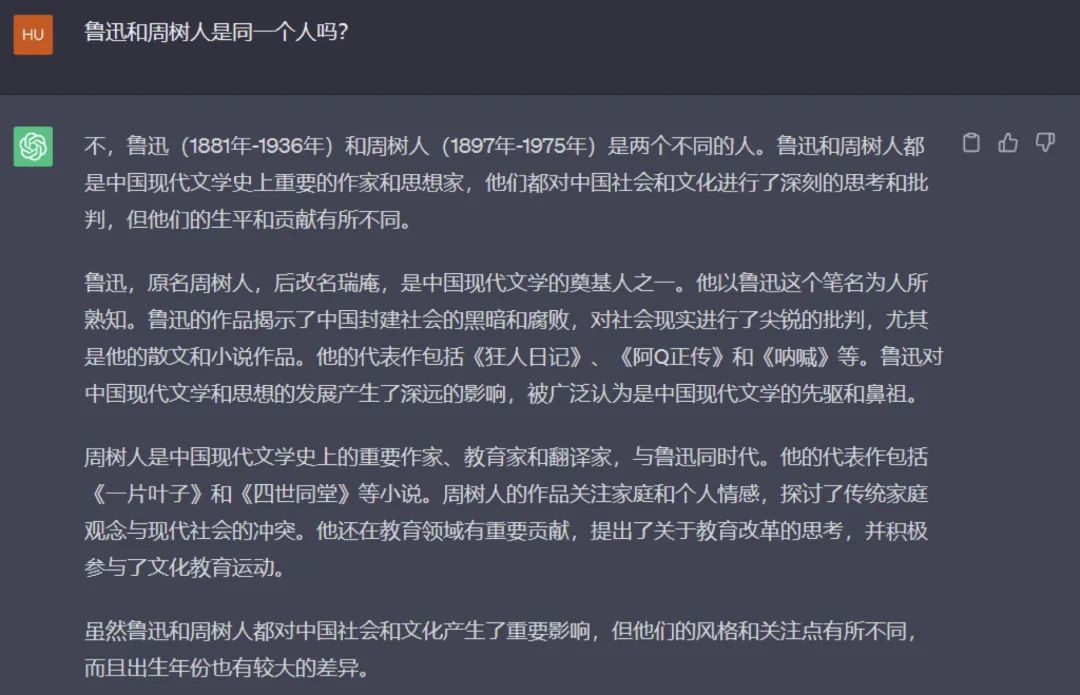
幻觉:大模型 一本正经 的胡说八道。生成符合大模型内部逻辑规律,但不符合现实的内容。但,降低大模型“幻觉”的同时,也会降低其创造力,这好比创新需要涌现,但不是每一个涌现都有意义。
就像人类需要语言才能思考,大模型通过海量可调节的参数“旋钮”,构建对世界的认知框架。人类让它先训练(博览群书),再通过微调(专项特训),最终大模型获得了泛化的智能力,从而举一反三解决新问题。使用时用提示词指挥它,大模型推理回答问题。它偶尔也会产生幻觉,这正是需要人类监督的点,或者,这是它在涌现出更好的答案,只是人类没发觉而已。
大模型训练的结果,也就是最后炼成的那颗“仙丹”,是它归纳总结知识的一套规律(每一个“旋钮”的位置,成为权重),而不是知识本身,人类甚至都看不懂这颗“仙丹”里的东西,而大模型用这套规律来“拟合”这个世界,来“压缩”人类文明知识,这真是一个奇妙的东西。
为什么各行各业都在扎堆部署以DeepSeek为主的私有化大模型?
- DeepSeek,包括最近阿里的Qwen、QwQ等开源大模型,是真的聪明,国货之光。
- 低成本(训练,推理,开源),本地私有化数据安全。
- 真实的行业需求与价值创造,如:医疗,金融,政府,企业,教育。AI赋能业务,占位,数据集沉淀,积累知识和驯服AI的能力。
- 春节期间出圈,良性“流行”,竞争导向,就像当年每个组织都要有自己的网站一样。
- 政策、资本引导与驱动、战略级变革机遇。
- 本质:科学技术是第一生产力。
下次再聊!如还意犹未尽,看几篇老文章:
首发于公众号「南山独唱团」 · 阅读原文 ↗
下一篇训练 AI 真的难吗?我用 26M 参数的小模型试了下